Webサイトには「robots.txt」という小さなファイルがある。サイトの玄関に貼る張り紙のようなもので、検索エンジンやAIのプログラムに「このページは読んでよい/ここはダメ」と伝える役割を持つ。
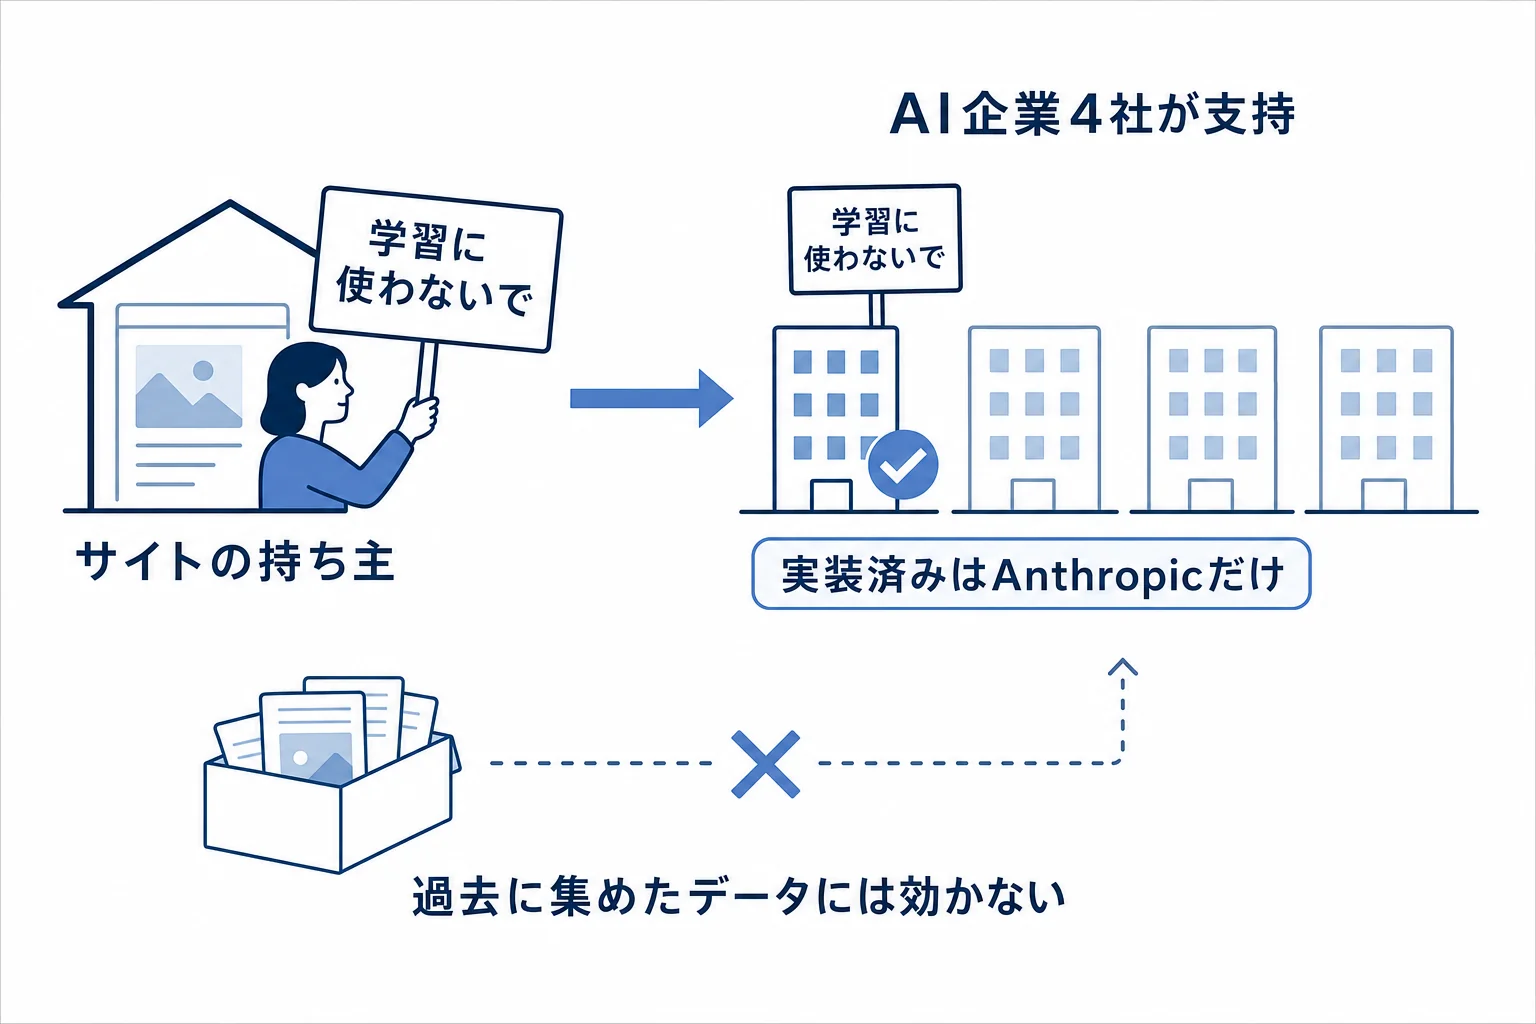
いまAI企業ごとにバラバラだったこの設定を統一し、共通の目印を1つ書くだけで「AIの学習に使わないで」と全社に伝えられる仕組みを作ろうという動きが出ている。OpenAI・Google・Microsoft・Anthropicの米AI大手4社がこの仕組みを支持すると発表した(Impress Watch、2026年11月1日)。
ただし対応を始めたのはAnthropicだけで、残り3社は表明の段階だ。すでにAIが学習に使ったデータを取り消す力もない。
サイト管理者はAI企業ごとの設定を1つにまとめられる
現状では、AIに自社サイトを読ませたくない場合、AI企業ごとにクローラー(情報を自動で集めるプログラム)の名前を調べ、robots.txtに1社ずつ「入らないで」と書く必要がある。会社が増えれば、書く行も管理の手間も増える。
今回の仕組みでは、「__usage_ai-training」という共通の目印(ポリシートークン)をrobots.txtに1つ書くだけで、参加する全社に「学習には使わないで」と一度に伝えられる(The Verge報道)。個別のAI企業名を調べる手間がなくなる。
この仕組みは4社が独自に決めるのではなく、インターネットの技術ルールを定める国際組織IETF(Internet Engineering Task Force)の「AI Preferences」ワーキンググループで協議されている。現時点では個人が提出したドラフト(草案)の段階で、正式な国際標準にはなっていない。草案の作成者はAnthropicのKevin Kelley氏だ。
対応を始めたのはアンソロピック1社だけ
4社のなかで対応を始めたと報じられているのはAnthropic(アンソロピック)だけだ(The Verge報道)。Anthropicは草案の作成者を出している企業でもある。
ほかの3社は「支持する」「導入する」と表明した段階で、サイト管理者が今すぐ使える状態ではない。
各社の対応時期にはばらつきがある
4社の足並みは揃っていない。具体的な日付を示しているのはMicrosoftだけで、OpenAIの「数カ月以内」は目標にとどまる。
| 会社 | 対応の時期 |
|---|---|
| アンソロピック | 対応を開始(詳細は未公表) |
| OpenAI | 今後数カ月以内の導入を目指す |
| マイクロソフト(Microsoft) | 2027年2月から適用する方針 |
| グーグル(Google) | 2027年に導入予定 |
グーグルとマイクロソフトは独自の細かい設定も残す
共通の目印ができても、各社が持つ独自のクローラー制御はなくならない。共通の目印は全社に大まかな意思を伝える役割で、細かい指定は各社の設定が担う。
Googleは、細かい設定に引き続き「Google-Extended」を使う。検索のクロールは許可したまま、Geminiの学習だけを拒否するといった使い分けができる。共通の目印で拒否し、Google-Extendedを明示していない場合は、Google-Extendedも拒否したものとして扱われる。
Microsoftは、共通の目印に加えて2つの設定を足す。1つは、サイト全体ではなく特定のページだけ学習を拒否できるページ単位の設定だ。もう1つは「グラウンディング」の設定で、AIが質問に答えるとき、その場でWebページを読んで回答の根拠にすることを指す。事前に覚え込ませる「学習」とは別に、回答の場面で読まれるかどうかも決められるようになる。
過去に学習済みのデータは取り消せない
この仕組みには少なくとも3つの限界がある。
1つ目は、効くのが「これから先の収集」だけという点だ。robots.txtはプログラムが読みに来たときに見る張り紙にすぎず、すでにAIが学習に使ったデータを消す力はない。過去に集められた分は対象外のままだ。
2つ目は、守るかどうかが各社の判断に委ねられている点だ。robots.txtは技術的な「お願い」であり法的な「命令」ではない。AIサービスのなかにはrobots.txtを無視して情報を集めるケースも多く、日本では新聞協会らがこの点を問題視していると報じられている。今回の4社以外のAI企業がどう動くかも分からない。
3つ目は、各社のクローラーへの正式な組み込みがまだこれからという点だ。ドラフトには目印の名前(__usage_ai-training)が載っているが、今すぐrobots.txtに書いても全社で意図どおりに動く保証はない。
今できることとしては、自社サイトのrobots.txtを開いて現状を確認しておくことだろう。Google-Extendedなど、AI学習用クローラー向けの個別設定がすでに入っているか。検索のクロールは許可したまま、AI学習だけを拒否する設定になっているか。この2点を確かめておけば、共通の仕組みが正式に動き始めたときの準備になる。
出典
本記事の根拠は次の報道である。
- Impress Watch(2026年11月1日): https://www.watch.impress.co.jp/docs/news/2152852.html
- The Verge(2026年10月30日、AI Weeklyによる要約): https://aiweekly.co/alerts/openai-google-microsoft-anthropic-back-one-ai-opt-out-token
共通の目印の仕様(IETFドラフト「Machine-Readable Training Preference Signal」、作成者: AnthropicのKevin Kelley氏)はIETFのサイトで公開されている。